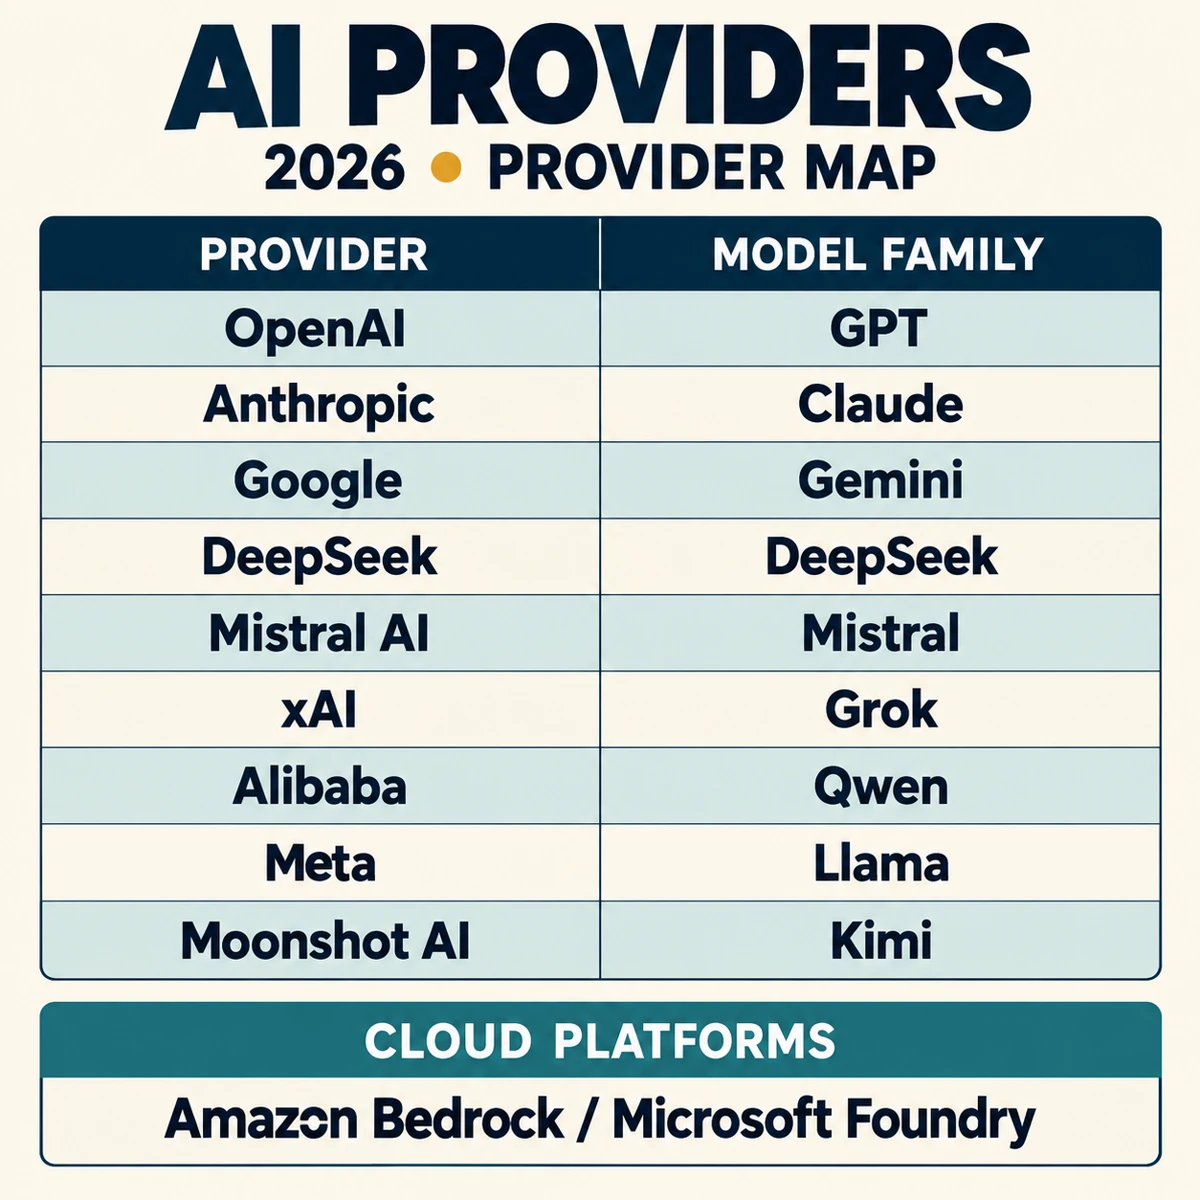
اگر برای نوشتن متن، کمک به برنامهنویسی یا ساخت یک دستیار سراغ هوش مصنوعی بروید، خیلی زود با چند اسم روبهرو میشوید: OpenAI، Anthropic، Google، DeepSeek و چند شرکت دیگر. انتخاب از روی اسم برند کافی نیست. باید بدانید هر شرکت چه چیزی ارائه میدهد و قرار است چه کاری به آن بسپارید.
این راهنما، ارائهدهندگان مطرح هوش مصنوعی در سال ۲۰۲۶ را برای استفاده در کار و محصول معرفی میکند. «برتر» در اینجا به معنی یک رتبهبندی قطعی نیست؛ اینها گزینههایی برای بررسیاند و انتخاب مناسب به نیاز شما بستگی دارد. اطلاعات مدلها در ۸ اکتبر ۲۰۲۶ بررسی شده است. این فهرست درباره بازار جهانی است و به معنی عرضه همه این سرویسها در طراحستان نیست.
ارائهدهنده، مدل و اپلیکیشن چه فرقی دارند؟
OpenAI نام شرکت است، GPT نام خانواده مدلهای آن و ChatGPT محصولی است که کاربر با آن کار میکند. همین تفاوت را بین Anthropic و Claude، یا Google و Gemini میبینید. API هم راهی است که نرمافزار شما از طریق آن به مدل درخواست میفرستد؛ مثلاً برای خلاصهکردن یک متن در پنل سایت.
یک تفاوت دیگر هم در انتخاب اثر دارد: بعضی شرکتها مدل میسازند و بعضی پلتفرمها دسترسی به مدلهای چند شرکت را فراهم میکنند. مدل یکسان روی دو پلتفرم ممکن است قیمت، محدودیت درخواست یا امکانات متفاوتی داشته باشد.
OpenAI؛ برای متن، کدنویسی و کار با ابزارها
OpenAI مدلهای GPT را از طریق API در اختیار توسعهدهندگان میگذارد. در مستندات فعلی، GPT-6 Astra برای استدلال و کدنویسی پیچیده، GPT-6.1 Sol برای توازن کیفیت و هزینه، و GPT-6 Luna برای کارهای پرتعداد و حساس به هزینه معرفی شدهاند. مدلهای جدید ورودی متن و تصویر میگیرند و خروجی متنی تولید میکنند. منبع: فهرست رسمی مدلهای OpenAI
برای پروژهای که دستیار باید از ابزارها استفاده کند یا داده را به شکل مشخص برگرداند، این خانواده ارزش آزمایش دارد. پیشنهاد عملی ما این است که ابتدا یک مدل متناسب با بودجه را روی نمونههای واقعی امتحان کنید و فقط اگر کیفیت کافی نبود، سراغ مدل پرهزینهتر بروید. این پیشنهاد روش انتخاب است، نه نتیجه یک مقایسه آزمایشگاهی بین برندها.
Anthropic؛ خانواده Claude و کارهای طولانی
Anthropic سازنده Claude است. فهرست فعلی آن شامل Fable 5.1، Opus 5.5، Sonnet 5.5 و Haiku 5.5 است. شرکت، Fable را برای استدلال دشوار و کارهای طولانی عاملها، Opus را برای کدنویسی و کار دانشی، و Haiku را برای وظایف پرتعداد و حساس به تأخیر معرفی میکند. این مدلها از ورودی متن و تصویر و استفاده از ابزار پشتیبانی میکنند. منبع: مقایسه رسمی مدلهای Claude
اگر قرار است یک دستیار چند مرحله از کار را پیش ببرد، Claude یکی از گزینههای فهرست آزمایش شماست. برای متن فارسی هم خروجی را با نوشتههای خودتان بسنجید: لحن، دقت اصطلاحات و مقدار ویرایش لازم مهمتر از یک پاسخ نمونه زیبا هستند.
Google؛ Gemini برای ورودیهای مختلف
Google مدلهای Gemini را از طریق Gemini API ارائه میکند. فهرست رسمی آن، مدلهای عمومی و مدلهای مخصوص تصویر و صدا را جدا کرده و وضعیت نسخههای پیشنمایش را هم مشخص میکند. بنابراین برای پروژهای که با متن، تصویر یا صدا کار دارد، باید مدل مناسب همان ورودی و خروجی را انتخاب کنید؛ همه مدلهای Gemini امکانات یکسانی ندارند. منبع: مدلهای Gemini API
در ساخت محصول، نام دقیق مدل و وضعیت انتشار آن را ثبت کنید. نسخه پیشنمایش را با نسخه پایدار یکی نگیرید و قبل از اتصال به سرویس اصلی، محدودیتهای آن را بخوانید.
DeepSeek؛ یک گزینه دیگر برای اتصال از طریق API
DeepSeek در راهنمای فعلی API خود، مدلهای deepseek-flash و deepseek-v4-pro را معرفی میکند. قالب API آن با قالبهای OpenAI و Anthropic سازگار است و مستندات، روش استفاده از ابزارها و SDKهای سازگار را توضیح میدهند. منبع: راهنمای رسمی DeepSeek API
این سازگاری برای تیمی که میخواهد ارائهدهنده دیگری را امتحان کند مفید است، اما انتقال را کامل نمیکند. رفتار استفاده از ابزار، خطاها و کیفیت پاسخ را در برنامه خودتان بررسی کنید. کمهزینهبودن را هم از روی نام شرکت فرض نکنید؛ قیمت مدل انتخابی و تعداد درخواستهای واقعی را حساب کنید.
Mistral؛ مدلهای عمومی، پردازش سند و صدا
Mistral هم مدلهای تجاری دارد و هم مدلهایی با وزنهای منتشرشده. در فهرست فعلی، مدلهای عمومی در کنار OCR برای استخراج متن و ساختار سند و Voxtral برای پردازش صدا دیده میشوند. نوع مجوز هم برای هر مدل جدا مشخص شده است. منبع: فهرست مدلهای Mistral
اگر کار شما بیشتر خواندن فایل و استخراج اطلاعات است، یک مدل تخصصی پردازش سند را هم در مقایسه بگذارید. اگر قصد اجرای مدل روی زیرساخت خودتان را دارید، انتشار وزنها را با رایگانبودن اجرای آن اشتباه نگیرید؛ هزینه سختافزار و نگهداری و شرایط مجوز باقی میمانند.
Grok؛ مدلها و ابزارهای جستوجو
API مدلهای Grok در دامنه x.ai مستند شده است. مستندات آن تولید متن، درک تصویر، خروجی ساختاریافته و ابزارهای جستوجوی وب و X را پوشش میدهند. برای کاربردی که به این ابزارها نیاز دارد، Grok هم گزینهای برای بررسی است. منبع: مستندات رسمی Grok API
دسترسی به جستوجو را با درستبودن خودکار پاسخ یکی نگیرید. اگر خروجی قرار است خبر یا گزارش شود، لینک منبع و تاریخ مطلب را بررسی کنید و نتیجه جستوجو را از تفسیر مدل جدا نگه دارید.
Alibaba Cloud؛ خانواده Qwen در Model Studio
Model Studio در Alibaba Cloud، خانواده Qwen و مدلهای شرکتهای دیگر را از طریق API ارائه میکند. مستندات، Qwen-Max را برای کارهای پیچیده، Qwen-Plus را برای توازن کیفیت و هزینه و Qwen-Flash را برای کارهای ساده و سریع معرفی میکنند. امکانات چندرسانهای هم بسته به مدل در دسترساند. منبع: معرفی رسمی Model Studio
در این پلتفرم، منطقه انتخابی روی آدرس اتصال، مدلهای موجود و قیمت اثر دارد. قبل از پیادهسازی، مستندات همان منطقهای را بخوانید که قرار است پروژه در آن اجرا شود.
Meta؛ خانواده Llama و انتخاب محل اجرای مدل
Meta سازنده خانواده Llama است. مخزن رسمی آن، مدلها، کارتهای مدل و شرایط مجوز را منتشر میکند و مسیر دریافت وزنها و اجرای مدل را توضیح میدهد. این مسیر برای تیمی که میخواهد مدل را روی زیرساخت خودش اجرا کند یا میزبان آن را انتخاب کند، ارزش بررسی دارد. منبع: مخزن رسمی مدلهای Llama
Llama را با اپلیکیشن Meta AI یکی نگیرید. در پروژهای که از وزنهای مدل استفاده میکند، انتخاب نسخه، سختافزار و سرویسدهی به عهده تیم یا میزبان منتخب است. وزنهای منتشرشده به معنی نبودن محدودیت مجوز یا هزینه نیستند؛ شرایط همان نسخه را بخوانید و هزینه اجرای آن را کنار APIهای آماده مقایسه کنید. برای کار فارسی هم کیفیت را روی نمونههای خودتان بسنجید.
Moonshot AI؛ خانواده Kimi برای متن، کدنویسی و کار با فایل
Moonshot AI سازنده مدلهای Kimi است. راهنمای رسمی Kimi API، تولید متن، گفتوگوی چندمرحلهای، پردازش فایل و جستوجوی وب را از امکانات پلتفرم معرفی میکند. پلتفرم توسعهدهندگان هم مدلهایی برای ورودی متن و تصویر و کارهای عاملهای کدنویسی ارائه میکند. منبع: معرفی رسمی Kimi API؛ منبع: پلتفرم رسمی توسعهدهندگان Kimi
برای پروژهای که باید با فایلها و گفتوگوهای طولانی کار کند، Kimi را هم در فهرست آزمایش بگذارید. امکانات اپلیکیشن Kimi را به همه مدلهای API تعمیم ندهید؛ پشتیبانی از تصویر، طول ورودی و ابزارها را برای مدل انتخابی بررسی کنید. خواندن یک فایل طولانی هم تضمین نمیکند همه جزئیات آن درست استخراج شوند؛ پاسخ را با بخشهای مشخص سند تطبیق دهید.
Amazon Bedrock و Microsoft Foundry؛ دسترسی سازمانی به چند مدل
Amazon Bedrock دسترسی به مدلهای چند ارائهدهنده را فراهم میکند. Microsoft Foundry هم مدلها، عاملها و ابزارها را همراه با امکانات مدیریت دسترسی و پایش در یک پلتفرم جمع میکند. برای تیمی که زیرساختش روی AWS یا Azure است، بررسی این مسیر کنار API مستقیم شرکت سازنده مفید است. منبع: Amazon Bedrock؛ منبع: Microsoft Foundry
این پلتفرمها را در مقایسه کنار شرایط استقرار پروژه بگذارید. موجودبودن یک مدل در API مستقیم سازنده، تضمین نمیکند همان نسخه در منطقه ابری شما هم عرضه شده باشد.
برای کار خودمان کدام را انتخاب کنیم؟
این جدول یک نقطه شروع برای آزمایش است؛ پیشنهادها برداشت کاربردی از امکانات مستندشدهاند و رتبهبندی کیفیت نیستند.
| نیاز شما | گزینههای قابل بررسی | چیزی که باید بسنجید |
|---|---|---|
| نوشتن و ویرایش متن فارسی | GPT، Claude، Gemini، Qwen، Llama و Kimi | لحن، صحت محتوا و زمان ویرایش انسانی |
| کمک به برنامهنویسی و ساخت دستیار | OpenAI، Anthropic، DeepSeek و Moonshot AI | درستی کد و موفقیت در کار با ابزارها |
| خواندن سند و استخراج اطلاعات | Mistral OCR و مدلهای دارای ورودی تصویر | دقت روی فایلهای واقعی شما |
| کار با صدا یا تصویر | مدلهای تخصصی Google، Mistral، Grok و Qwen | نوع ورودی و خروجی پشتیبانیشده در همان مدل |
| اجرای مدل روی زیرساخت منتخب | Meta Llama و مدلهای دارای وزنهای منتشرشده Mistral | مجوز، نیاز سختافزاری و هزینه نگهداری |
| کار با فایل و گفتوگوهای طولانی | Kimi و مدلهای دارای ظرفیت ورودی متناسب | دقت استخراج و حفظ جزئیات سند |
| مدیریت چند مدل در زیرساخت ابری | Amazon Bedrock و Microsoft Foundry | منطقه، دسترسی، پایش و هزینه کل |
برای تصمیم اولیه، ۱۰ تا ۲۰ نمونه از کارهای واقعیتان بردارید و با شرایط مشابه به چند مدل بدهید. کیفیت پاسخ، زمان انتظار، خطا و هزینه هر کار را ثبت کنید. اگر یک مدل ارزانتر چند بار نیاز به تکرار یا اصلاح دارد، هزینه نهاییاش ممکن است از مدل گرانتر بیشتر شود.
برای استفاده از داخل ایران، شرایط رسمی دسترسی کشورها و پرداخت هر ارائهدهنده را پیش از خرید بررسی کنید. این مقاله امکان دسترسی از ایران را تأیید نمیکند. درباره دادههای کاری هم سیاست نگهداری داده همان سرویس و همان نوع حساب را بخوانید.
خروجی این آزمایش باید یک تصمیم مشخص باشد: کدام مدل برای کدام کار، با چه سقف هزینه و چه میزان بازبینی انسانی استفاده شود. نام دقیق مدل و تاریخ بررسی را کنار این تصمیم نگه دارید تا هنگام تغییر سرویس، بتوانید دوباره همان نمونهها را آزمایش کنید.

هنوز دیدگاهی ثبت نشده
اولین نفری باشید که نظر میدهد!