

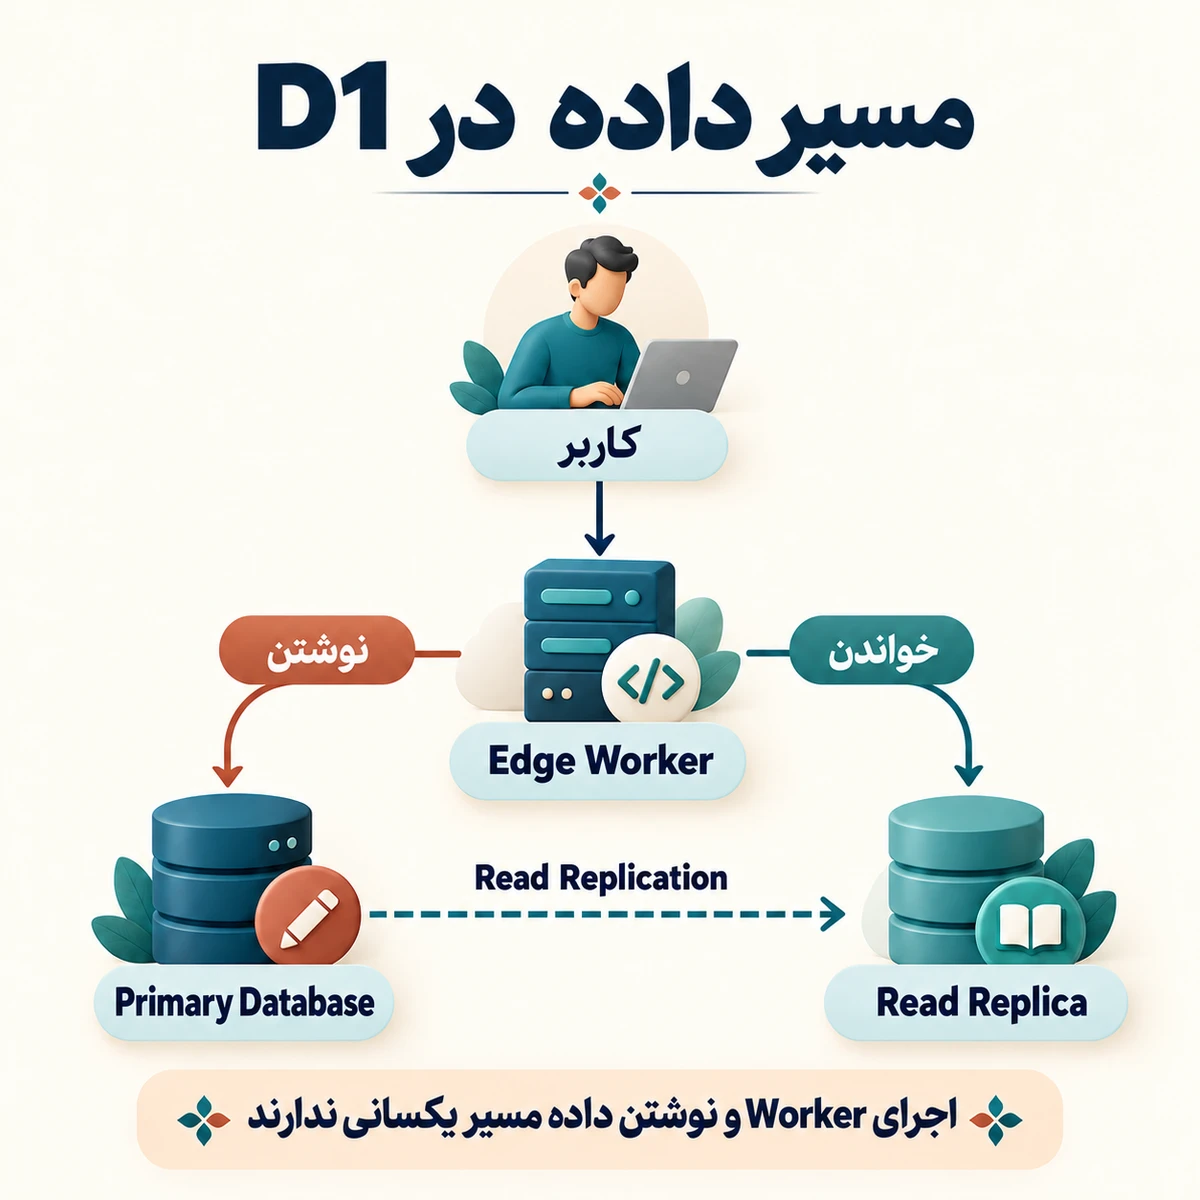
اجرای Edge Worker نزدیک کاربر به این معنی نیست که هر بار نوشتن داده هم در نزدیکترین نقطه انجام میشود. این تفاوت برای فهم Cloudflare D1 ضروری است. اگر کاربر اطلاعات پروفایل را تغییر دهد و بلافاصله صفحه را تازه کند، برنامه باید رفتار خواندن پس از نوشتن را درست طراحی کرده باشد. نام «Edge Database» بهتنهایی درباره مسیر داده، تازگی نتیجه یا زمان پاسخ چیزی را تضمین نمیکند.
این مقاله در ۹ اکتبر ۲۰۲۶ با مستندات رسمی بازبینی شده است. وعده عمومی تأخیر زیر ده میلیثانیه و ارزانتر بودن قطعی از سرویسهای دیگر حذف شدهاند. SQL execution time با End-to-end latency درخواست کاربر یکسان نیست. مثالها آموزشیاند و نتیجه اندازهگیری یک سامانه واقعی نیستند. برای انتخاب، داده و الگوی Query پروژه خود را به محدودیتها و قابلیتهای فعلی سرویس تطبیق دهید.
D1 چه نوع سرویسی است؟
طبق معرفی رسمی D1، D1 یک Serverless Database مدیریتشده توسط Cloudflare است که از SQL semantics در SQLite استفاده میکند. برنامه میتواند از مسیرهایی مانند اتصال Worker و API با آن کار کند. داشتن قواعد آشنای SQL شروع را آسانتر میکند، اما سازگاری را با همسان بودن کامل همه پایگاههای داده اشتباه نگیرید. قابلیت و محدودیت دقیق Query موردنیاز را از مستندات همان محصول بخوانید.
برای برنامهای که در Workers اجرا میشود، D1 میتواند بخشی از مسیر نگهداری داده رابطهای باشد. مثال ساده، جدول کاربران و تنظیمات یا اطلاعات یک فهرست محتوایی است. مناسب بودن این انتخاب از تعداد جدولها بهتنهایی معلوم نمیشود. حجم داده، نسبت Read به Write، نیاز به Transaction و طراحی Multi-tenancy تعیینکنندهاند. Transaction مجموعه عملیات با قرارداد مشخص برای موفقیت یا شکست است؛ Multi-tenancy هم به اداره داده چند مشتری یا Tenant در یک سامانه اشاره دارد. پیش از انتقال یک سامانه موجود، این نیازها را مستند کنید.
Primary Database و Read Replica چه تفاوتی دارند؟
در راهنمای Read Replication در D1، Primary Database محل اصلی ثبت Write است و Read Replica نسخهای فقطخواندنی از داده را برای پاسخ به Read Queryها نگه میدارد. Read Replication به فرایند ساخت و بهروز نگه داشتن این Replicaها اشاره دارد. Replicaها برای افزایش ظرفیت Read و کاهش فاصله برخی درخواستها به کار میآیند. وضعیت فعال بودن و محدودیت این قابلیت را برای حساب خود بررسی کنید. نباید تصور کرد هر Edge location مستقلاً محل Write همان Database است.
این مسیر را برای محصول خود رسم کنید: درخواست کاربر به Worker میرسد، Worker نیاز داده را مشخص میکند و Query به محل مناسب میرود. اگر نتیجه از کش پاسخ داده شود، مسیر دیگری وجود دارد که باید جدا بررسی شود. مقاله CDN و پردازش لبه تفاوت کش و اجرا را توضیح میدهد. نزدیک بودن Worker، تأخیر مسیر بعدی به Primary Database را از بین نمیبرد.
Session، Bookmark و Sequential Consistency
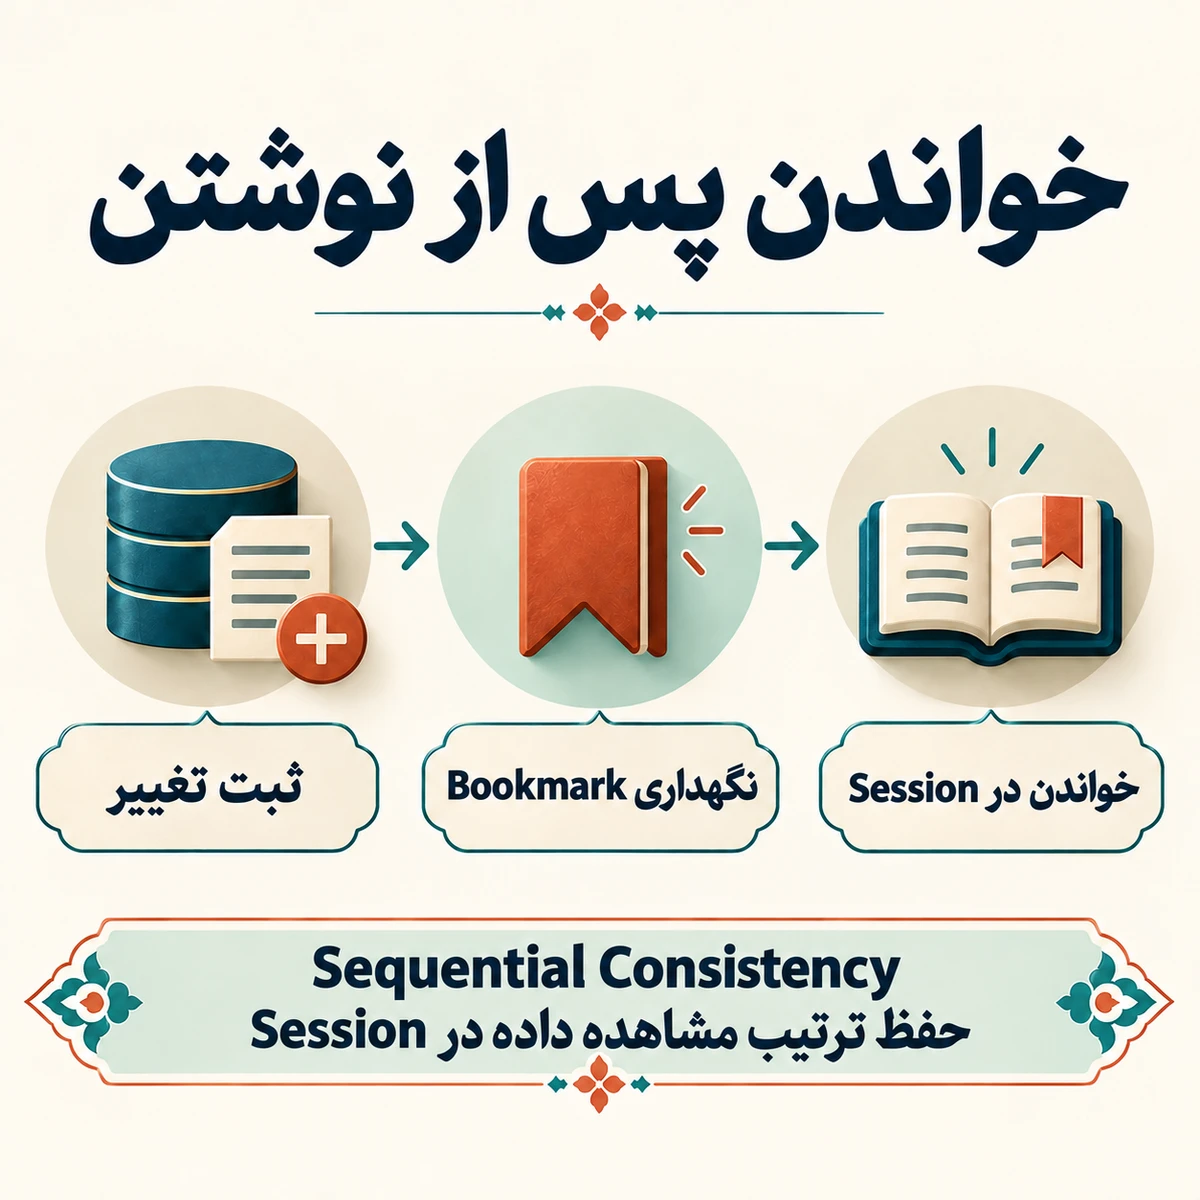
D1 Sessions API برای Sequential Consistency استفاده میشود: Queryهای یک Session با ترتیبی سازگار از نسخه داده پاسخ میگیرند و مشاهده داده به نسخهای قدیمیتر از زمینه آن Session برنمیگردد. Bookmark زمینه نسخه مشاهدهشده داده را مشخص میکند؛ برنامه آن را به Session بعدی منتقل میکند تا آن Session از نسخهای حداقل به تازگی Bookmark شروع شود. شروع با first-primary اولین Query را به Primary Database میبرد؛ شروع بدون قید، الزام مشابهی برای تازهترین نسخه ندارد. Sequential Consistency را با بهروز بودن همزمان همه Replicaها برای همه کاربران یکی نگیرید. Session در این API نیز با Login Session یا Session احراز هویت کاربر متفاوت است.
در مثال فرضی پروفایل، پاسخ ثبت تغییر میتواند Bookmark مربوط به Session را به مسیر خواندن بعدی برساند. برنامه نباید Bookmark را مجوز دسترسی بداند؛ احراز هویت و بررسی مالکیت داده همچنان لازماند. اگر مسیر Bookmark میان دو درخواست قطع شود، درباره تجربهای که کاربر خواهد دید فکر کنید. درخواست مستقل یک کاربر دیگر نیز زمینه جدا دارد. جزئیات API و قرارداد انتقال Bookmark را از همان مستندات رسمی پیاده کنید.
از Binding تا Prepared Statement
راهنمای Query D1 استفاده از Binding، ساخت Prepared Statement و اتصال مقدارها با متد bind() را نشان میدهد. Binding اتصال نامگذاریشده Database به Worker از طریق تنظیمات است. Prepared Statement ساختار SQL را از مقدارهای ورودی جدا نگه میدارد. در برنامه، ورودی کاربر را با چسباندن رشتهها به SQL تبدیل نکنید. ساختار Query و مقدار ورودی باید جدا باشند. پارامتری کردن مقدار، همه کنترلهای امنیتی را انجام نمیدهد؛ برنامه هنوز باید نقش کاربر و اجازه مشاهده یا تغییر رکورد را بررسی کند.
برای یک فهرست سفارش، شرط مربوط به مشتری را در همان مرز دسترسی اعمال کنید. کاربر نباید با تغییر شناسه، رکورد فرد دیگری را ببیند. اعتبارسنجی ورودی هم پیش از رسیدن به پایگاه لازم است. راهنمای Zod و اعتبارسنجی TypeScript درباره این مرز توضیح میدهد. معتبر بودن شکل یک شناسه، به معنی مجاز بودن دسترسی به داده آن شناسه نیست.
Schema را از مسیرهای محصول بسازید
Schema ساختار جدولها، ستونها و Constraintها را مشخص میکند. قبل از ساخت جدول، چند عملیات اصلی را بنویسید: نمایش فهرست، جستوجوی رکورد، ثبت تغییر و گزارشگیری. هر عملیات چه ستونهایی میخواهد و چند رکورد را میخواند؟ این سؤال از ساخت یک جدول عمومی برای همه دادهها مفیدتر است. در مثال فرضی سامانه رزرو، وضعیت و زمان رزرو باید قرارداد روشنی داشته باشند. تغییر نام وضعیت در رابط نباید بدون تصمیم مشخص معنای داده قدیمی را عوض کند.
Constraintها، شناسهها و رابطهها را متناسب با قابلیتهای پشتیبانیشده طراحی کنید. اگر عملیات چندمرحلهای است، رفتار شکست میان مراحل را روشن کنید و از پشتیبانی دقیق Transaction یا batch() در API انتخابی مطمئن شوید. یک ORM این پرسشها را حذف نمیکند. هرجا ORM تولید SQL را پنهان میکند، خروجی آن را بفهمید تا تعداد Query و حجم داده خواندهشده از کنترل خارج نشود.
Index، هزینه خواندن و هزینه نوشتن
راهنمای Index D1 نقطه شروع مناسبی برای بررسی Queryهای پرتکرار است. Index را از شرط فیلتر و ترتیب نتیجه انتخاب کنید. ساخت Index برای همه ستونها راهحل عمومی نیست؛ نگهداری آن روی نوشتن و حجم ذخیرهسازی اثر دارد. اگر صفحه تنها چند نتیجه نشان میدهد، خواندن مجموعه بزرگی از رکوردها و فیلتر کردن در Worker معمولاً انتخابی است که باید بازنگری شود.
یک Query فهرست را با داده کم و داده بزرگتر بررسی کنید و Query Plan آن را بفهمید. صفحهبندی، انتخاب ستونهای لازم و جلوگیری از درخواست تکراری بخشهای دیگری از همین طراحیاند. نتیجه خوب روی ده رکورد برای پیشبینی رفتار هزاران رکورد کافی نیست. اگر رشد داده یکی از فرضهای محصول است، آن را از ابتدا در بررسی Queryهای مهم وارد کنید و فرضها را مستند نگه دارید.
محدودیت هر پایگاه را پیش از رشد بخوانید
در جدول فعلی محدودیتها، سقف حجم هر پایگاه برای طرح پولی ۱۰ گیگابایت و برای طرح رایگان ۵۰۰ مگابایت آمده است. این اعداد مربوط به زمان بازبینی مقالهاند و باید هنگام انتخاب دوباره بررسی شوند. همان صفحه توضیح میدهد هر نمونه پایگاه Queryها را به ترتیب پردازش میکند؛ مدت Query در ظرفیت عملی نقش دارد. یک پایگاه کوچک هم میتواند Queryهای پرهزینه داشته باشد.
تقسیم داده میان چند پایگاه میتواند برای جداسازی مشتریها بررسی شود، اما هزینه مدیریتی دارد. باید مسیریابی مشتری، اجرای Migration، گزارشگیری مشترک و حذف داده را برای همه پایگاهها طراحی کنید. دادهای که مرتب به اتصال میان مشتریها نیاز دارد، با جداسازی بیبرنامه دشوارتر میشود. قبل از انتخاب این مدل، Queryهای بین بخشها و روش اداره Schema Migrationها را روی کاغذ مشخص کنید.
هزینه را با تعداد ردیفها بفهمید
قیمتگذاری D1 هزینه خواندن ردیف، نوشتن ردیف و ذخیرهسازی را توضیح میدهد. تعداد درخواست HTTP بهتنهایی صورتحساب پایگاه را پیشبینی نمیکند. یک درخواست میتواند چند Query اجرا کند و هر Query تعداد متفاوتی ردیف بخواند. Index، الگوی جستوجو و کار پسزمینه را در برآورد وارد کنید. هزینه Worker و دیگر خدمات را هم جدا حساب کنید.
برای برآورد، عملیات معمول، اوج و کارهای دورهای را فهرست کنید. برای هرکدام تعداد اجرا و ردیفهای درگیر را تخمین بزنید و مشخص کنید کدام مقدار اندازهگیریشده و کدام فرضی است. آستانه هشدار تعیین کنید. مقایسه با سرویس دیگر باید نیاز یکسان، حجم یکسان و هزینه کل را در نظر بگیرد. عبارت «ارزانتر» بدون این زمینه برای تصمیم مالی پروژه قابل اتکا نیست.
Schema Migration و نگهداری داده
راهنمای Migration را برای نسخهگذاری تغییرهای پایگاه بخوانید. تغییر جدول باید با نسخه برنامه سازگار باشد. اگر کد قدیمی هنوز اجرا میشود، حذف ناگهانی ستون میتواند مسیر فعال را خراب کند. برای تغییر بزرگ، مراحل افزودن ساختار، انتقال داده و کنار گذاشتن ساختار قبلی را جدا طراحی کنید. محیط توسعه و اصلی را با نام و تنظیمات روشن از هم جدا نگه دارید.
بازیابی داده، خروجی گرفتن و دسترسی عملیاتی را پیش از نیاز اضطراری بشناسید. وجود قابلیت بازیابی در محصول به معنی مناسب بودن همه روشهای بازگردانی برای برنامه شما نیست. بدانید چه دادهای پس از نقطه بازیابی تغییر کرده و چگونه با سرویسهای دیگر هماهنگ خواهد شد. مالک عملیات و مسیر دریافت هشدار را مشخص کنید. این مقاله راهنمای انتخاب است و هیچ پایگاه موجودی را صرفاً برای نام Edge به مهاجرت توصیه نمیکند.
انتخاب برای یک مسیر محدود
برای شروع، یک کاربرد محدود با نیاز روشن انتخاب کنید و مسیر خواندن، نوشتن، مجوز، خطا و هزینه آن را توضیح دهید. End-to-end latency پاسخ را از دید کاربر بسنجید و زمان SQL را جدا ثبت کنید. اگر به سازگاری ویژه، حجم بزرگ یا عملیات متفاوت نیاز دارید، گزینههای دیگر را با همان معیار بررسی کنید. D1 وقتی انتخاب قابل دفاعی میشود که قرارداد داده و محدودیتهایش با محصول شما سازگار باشد.

هنوز دیدگاهی ثبت نشده
اولین نفری باشید که نظر میدهد!