

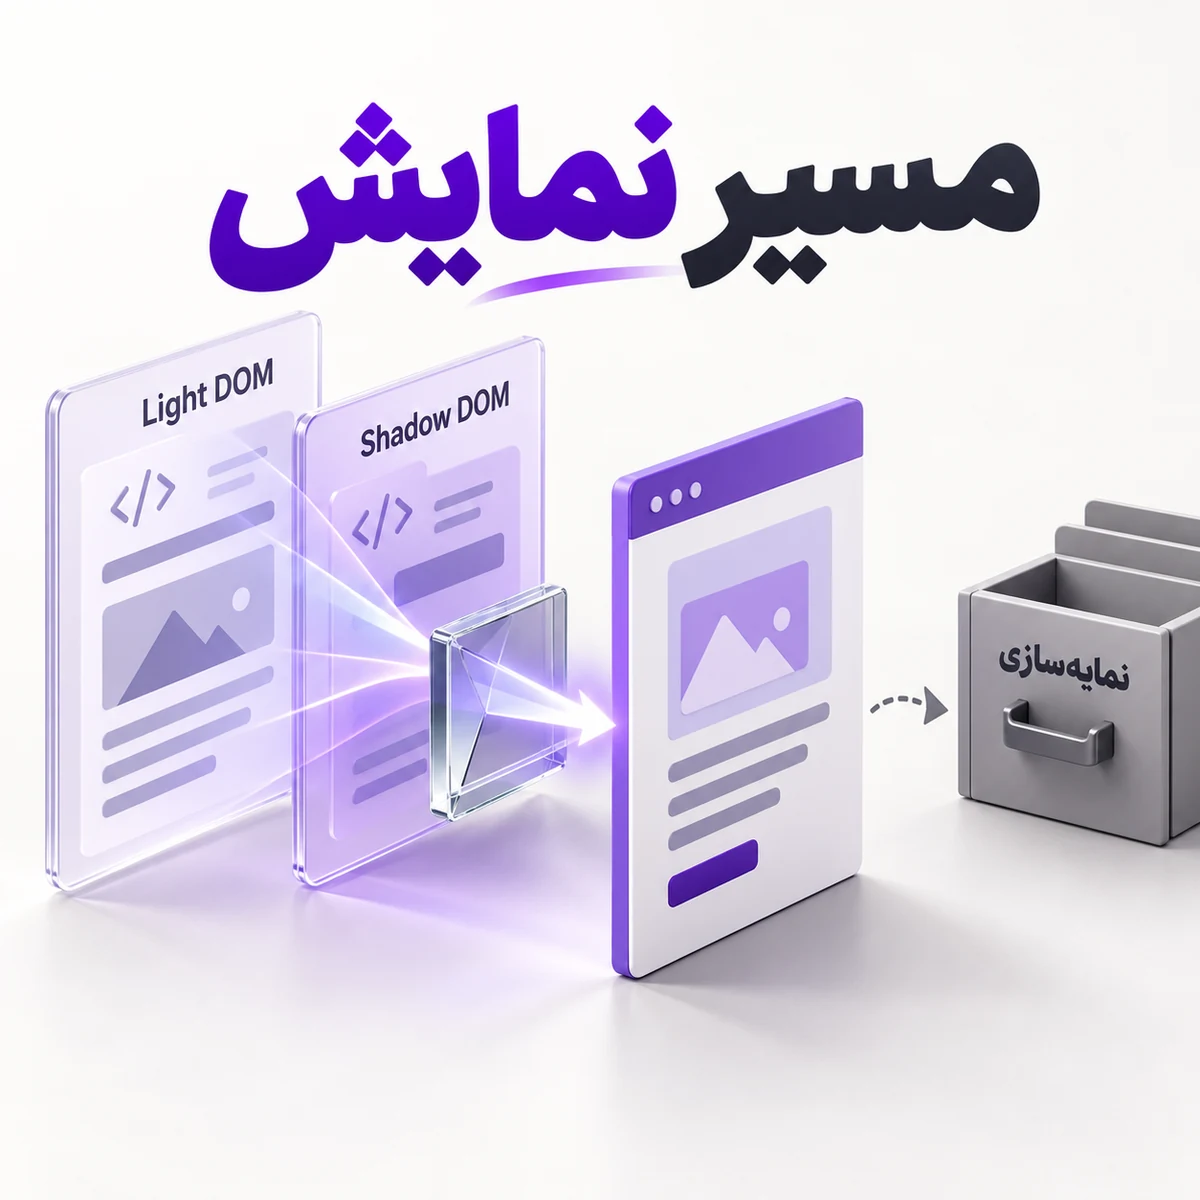
Shadow DOM به Web Component اجازه میدهد بخشی از ساختار و سبک داخلی خود را جدا نگه دارد. این جداسازی درباره مرز component است و به معنی نامرئیبودن قطعی محتوا برای Google نیست. راهنمای JavaScript SEO گوگل میگوید هنگام rendering، محتوای Shadow DOM و Light DOM را flatten میکند. بنابراین ادعای متن قبلی که این دو ادغام نمیشوند یا محتوا اصولاً ایندکس نمیشود، درست نبود. مسئله عملی این است که crawler چه چیزی را واقعاً میتواند دریافت و render کند و آیا آن محتوا برای کاربر هم نمایش داده میشود.
سه مرحله را از هم جدا کنید
Crawling دریافت صفحه و منابع مرتبط است، rendering اجرای لازم برای ساخت نمایش صفحه است و indexing تصمیم درباره استفاده از اطلاعات در جستوجوست. وجود محتوا در DOM مرحله اول همه این مراحل را تضمین نمیکند. صفحه میتواند قابل دریافت باشد، اما script لازم برای component بارگذاری نشود. ممکن است محتوای renderشده وجود داشته باشد، ولی سیاست noindex یا canonical موضوع دیگری ایجاد کند. اگر این مراحل را با هم ترکیب کنیم، هر مشکل صفحه به Shadow DOM نسبت داده میشود و علت واقعی پیدا نمیشود.
ابتدا ورودی HTML و منابع لازم را بشناسید. متن مهم از سرور میآید یا پس از درخواست API ساخته میشود؟ نمایش آن به تعامل کاربر وابسته است یا خودکار انجام میشود؟ اگر کاربر برای دریافت شرح محصول باید دکمهای را بزند، رفتار crawler لزوماً همان مسیر تعاملی کاربر نیست. این مسئله به نحوه تحویل محتوا مربوط است، حتی اگر component از Light DOM استفاده کند. معماری render مهمتر از برچسب کلی «Shadow DOM خوب یا بد برای SEO» است.
در پروژهای که چند نوع component دارد، مسیر محتوای اصلی را جدا ثبت کنید. یک دکمه تزئینی با یک بخش کامل مقاله مسئولیت یکسانی ندارد. برای متن اصلی، عنوان، لینک و داده ساختاریافته باید بدانید خروجی از کجا تولید میشود. کدی که فقط ظاهر را تغییر میدهد ریسک دیگری دارد تا کدی که تمام محتوای صفحه را از API دریافت میکند. با این تفکیک میتوان بررسی را روی بخش مؤثر متمرکز کرد و از بازنویسی بیدلیل همه componentها پرهیز کرد.
Shadow DOM چه چیزی را جدا میکند؟
یک custom element میتواند shadow root داشته باشد و عناصر داخلی خود را در آن قرار دهد. سبک داخلی از بعضی قواعد بیرونی جدا میشود و component کنترل بیشتری بر ساختارش دارد. slot راهی برای قرارگرفتن محتوای Light DOM در نمایش component است. این مدل باید در نمونه آموزشی با markup واقعی نشان داده شود. گفتن «همه چیز را در shadow بگذارید» بدون توضیح slot و مسیر محتوا، برای تیمی که نیاز به دسترسیپذیری و تحویل HTML دارد راهنمای کافی نیست.
جداسازی سبک به معنی مرز امنیتی کامل نیست. Shadow DOM را برای پنهانکردن اطلاعات محرمانه به کار نبرید. اگر داده به مرورگر رسیده، مسئله دسترسی به آن باید از سمت سرور و قرارداد داده حل شود. حالت open یا closed هم نباید به عنوان تضمین SEO یا امنیت معرفی شود. انتخاب آن به طراحی API component و ابزارهای مصرفکننده مربوط است. کاربر و crawler درباره نتیجه قابل نمایش صفحه نیاز دارند، نه صرفاً نام حالت attachShadow.
نمونه کامل با محتوای اصلی در HTML
نمونه زیر یک component معرفی راهنما دارد. عنوان، توضیح و لینک در HTML اصلی قرار گرفتهاند و component برای آنها چیدمان ساده میسازد. فایل را با نام shadow-guide.html ذخیره کنید و در مرورگر باز کنید؛ وابستگی و فایل خارجی ندارد. اگر JavaScript اجرا نشود، محتوای متن و لینک همچنان در document وجود دارند. این انتخاب برای نمونه به معنی الزام قرارگیری تمام محتوای هر پروژه در Light DOM نیست؛ نشان میدهد چگونه میتوان تحویل محتوا را از enhancement بصری جدا کرد.
<!doctype html>
<html lang="fa" dir="rtl">
<head>
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1">
<title>راهنمای Shadow DOM</title>
<style>body { font-family: sans-serif; line-height: 1.9; margin: 2rem; color: #172333; }</style>
</head>
<body>
<main>
<h1>یادگیری طراحی وب</h1>
<guide-card>
<h2 slot="title">راهنمای SEO برای کسبوکار</h2>
<p slot="body">محتوا و ساختار صفحه را بر پایه نیاز خواننده طراحی کنید.</p>
<a slot="link" href="/magazine/seo-iranian-businesses-practical-guide">خواندن راهنمای SEO</a>
</guide-card>
</main>
<script>
class GuideCard extends HTMLElement {
constructor() {
super();
const root = this.attachShadow({ mode: "open" });
root.innerHTML = `
<style>
:host { display: block; max-width: 40rem; }
.frame { border: 1px solid #b5c4d5; padding: 1rem; border-radius: .5rem; }
::slotted(a) { color: #174b8c; }
</style>
<section class="frame">
<slot name="title"></slot>
<slot name="body"></slot>
<slot name="link"></slot>
</section>`;
}
}
customElements.define("guide-card", GuideCard);
</script>
</body>
</html>
در این فایل، slotهای title، body و link با ویژگی slot عناصر بیرونی متناظرند. عنصر guide-card در HTML وجود دارد و customElements.define همان نام را ثبت میکند. stylesheet داخل shadow root فقط برای این component است. عنوان صفحه و h1 خارج از component قرار دارند تا ساختار کلی document روشن بماند. اگر نام slot را عوض میکنید، هر دو سمت تعریف و استفاده را تغییر دهید؛ در غیر این صورت ممکن است بخش مورد انتظار در جای درست نمایش داده نشود.
لینک نمونه از مسیر واقعی یک مقاله مرتبط استفاده میکند و یک anchor با href است. رفتار ناوبری را به کلیک روی div و کد پنهان وابسته نکردهایم. برای پروژه واقعی، URL مقصد باید از مسیرهای معتبر خودتان بیاید. استفاده از component دلیلی برای حذف قراردادهای ساده HTML نیست. دکمه برای اقدام و لینک برای ناوبری معنی مشخص دارند و همین معنا به دسترسیپذیری و فهم ساختار صفحه کمک میکند. ظاهر مشابه این دو، نقش آنها را برابر نمیکند.
تحویل سمت سرور و Declarative Shadow DOM
SSR میتواند محتوای قابل نمایش را در پاسخ اولیه بفرستد و وابستگی به اجرای JavaScript برای خواندن متن را کم کند. این مزیت به Shadow DOM محدود نیست. Declarative Shadow DOM هم راهی برای بیان ساختار shadow در HTML دارد، اما انتخاب آن باید با پشتیبانی مرورگر، ابزار ساخت و فرایند hydration هماهنگ باشد. استفاده از یک template با syntax تازه خودکار تمام مشکلات SEO را حل نمیکند. خروجی نهایی باید محتوای مورد انتظار و منابع لازم را داشته باشد.
اگر پس از SSR، کد مرورگر محتوای اولیه را جایگزین میکند، مراقب ازبینرفتن متن یا لینک باشید. داده سرور و داده client باید درباره هویت و وضعیت صفحه توافق داشته باشند. یک مرحله loading که متن موجود را پاک میکند ممکن است تجربه کاربر را بدتر کند. هدف hydration افزودن رفتار به خروجی موجود است، نه ایجاد دو روایت متفاوت از محتوا. خطا در این مرز میتواند به شکل «مشکل component» دیده شود، ولی علتش قرارداد داده و چرخه اجراست.
محتوا برای کاربر و موتور جستوجو یکسان باشد
اگر برای crawler متن جداگانهای میسازید که کاربر آن را نمیبیند، وارد مسئلهای متفاوت از fallback فنی میشوید. راهکار مناسب این است که محتوای مهم به شکل قابل دسترس به کاربر تحویل شود و enhancement آن را بهتر نمایش دهد. انباشتن کلمات کلیدی در بخش پنهان، راهحل rendering نیست. متن باید موضوع صفحه و نیاز خواننده را پوشش دهد. ساختار component نباید بهانهای برای افزودن نسخه نامرتبط محتوا فقط با هدف جستوجو شود.
عنوان document، canonical و robots را هم بررسی کنید. اگر client این مقادیر را تغییر میدهد، باید بدانید پاسخ اولیه و خروجی نهایی چه وضعیتی دارند. جلوگیری از crawl منابع ضروری میتواند rendering را تحت تأثیر قرار دهد. حذف noindex با JavaScript نیز نباید راهکار عادی معماری باشد. این تصمیمها در سطح صفحه قرار دارند و انتقال component از shadow به light به تنهایی اصلاحشان نمیکند. برای هر یافته، علت و محل اصلاح را مشخص نگه دارید.
Structured Data قرارداد خودش را دارد
وجود Shadow DOM به تنهایی ناسازگاری قطعی با Rich Results ایجاد نمیکند. داده ساختاریافته باید نوع مناسب، فیلدهای معتبر و تطابق با محتوای واقعی صفحه داشته باشد. اگر صفحه محصول است، اطلاعات ساختگی امتیاز یا موجودی اضافه نکنید. اگر محتوای component از API تغییر میکند، داده ساختاریافته نیز باید با وضعیت منتشرشده هماهنگ باشد. این هماهنگی مسئله داده است و با تغییر محل تگهای نمایشی خودکار برقرار نمیشود.
بهتر است مسئول تولید JSON-LD معلوم باشد. در پروژهای با چند component، تولید جداگانه چند روایت متعارض از یک محصول میتواند مشکل ایجاد کند. یک منبع داده مشترک و مالک مشخص به نگهداری کمک میکند. مقاله راهنمای عملی SEO درباره اتصال محتوا و نیاز جستوجو ادامه مناسبی دارد. نام ابزار یا نوع DOM جای اطلاعات درست درباره محصول، نویسنده و صفحه را نمیگیرد و هیچ علامت markup به تنهایی رتبه را تضمین نمیکند.
دسترسیپذیری را مستقل بررسی کنید
Component باید نام قابل فهم، ترتیب تعامل و نقش مناسب داشته باشد. Shadow DOM مسئولیت label، focus و ساختار معنایی را حذف نمیکند. در یک component فرم، ارتباط label و input را طبق ساختار واقعی بررسی کنید و فرض نکنید شناسه در هر دو سوی مرز به یک شکل کار میکند. در نمونه حاضر تنها متن و لینک داریم، بنابراین مسئله سادهتر است. افزودن ورودی یا dialog نیازمند قرارداد و پیادهسازی جداست، نه فقط اضافهکردن style به همان نمونه.
عنوانهای صفحه باید سلسلهمراتب روشن داشته باشند. اگر هر کارت بدون توجه به محل استفاده h1 میسازد، ساختار کلی ممکن است برای خواننده مبهم شود. API component میتواند سطح عنوان یا slot مناسب را به مصرفکننده بسپارد. طراحی component خوب میان encapsulation و امکان استفاده در صفحه واقعی تعادل برقرار میکند. درباره این تصمیم در مستندات کوتاه بنویسید تا همکار بعدی مجبور نباشد از ظاهر کارت حدس بزند چه headingی لازم است.
برای یافتن علت مشکل SEO، از مسیر محتوا شروع کنید: پاسخ اولیه، منابع، خروجی render و سیاست indexing را جدا بنویسید. سپس ببینید Shadow DOM در کدام مرحله اثر دارد. اگر متن مهم بدون JavaScript هم قابل تحویل است، SSR یا HTML پایه را بررسی کنید. اگر تعامل پویا ضروری است، رفتار آن را با نیاز crawler و کاربر هماهنگ کنید. این فرایند از ممنوعکردن کلی Web Components دقیقتر است و اصلاح را به علت واقعی وصل میکند.

هنوز دیدگاهی ثبت نشده
اولین نفری باشید که نظر میدهد!